บทที่ 9: Serving Data for Analytics, Machine Learning, and Reverse ETL
2 min readการสร้าง Trust ใน Data
ก่อน serving data ต้องมี trust ใน data ก่อน ถ้าคนไม่เชื่อถือ data จะไม่มีค่า
- Trust → Data products → Self-service → Data-driven culture
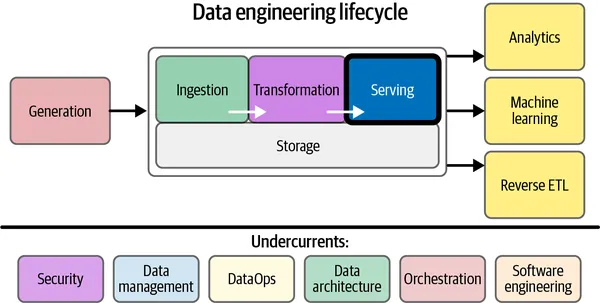 Figure 9-1. Serving delivers data for use cases
3 ประเภท Analytics
-
Business Intelligence (BI): อดีตและปัจจุบัน, reports, dashboards (แนวโน้ม self-service analytics)
- Self-service analytics: ทุกคน access data และ slice/dice เองได้ ทฤษฎีง่ายแต่ปฏิบัติยากเพราะ data quality
-
Operational Analytics: ปัจจุบัน, real-time, live view (inventory, system health)
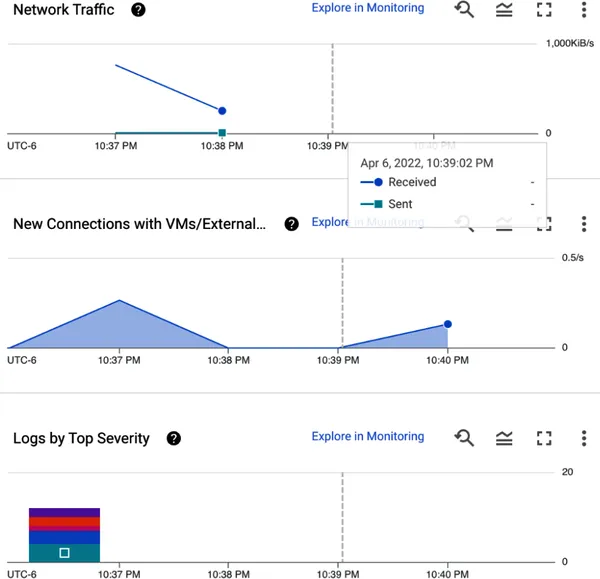 Figure 9-2. An operational analytics dashboard showing some key metrics from Google Compute Engine
-
Embedded Analytics: customer-facing เป็น hard ที่สุดเพราะต้องรับมือ 3 เรื่องพร้อมกัน: data latency (ต้องสดใหม่), query performance (ต้องเร็ว), concurrency (query rate สูงกว่ามาก จากลูกค้าหลายรายพร้อมกัน)
- Multitenancy: แต่ละ customer ต้องเห็นเฉพาะ data ของตัวเอง data leak คือ disaster
Machine Learning Serving
- Feature engineering → feature stores → model training → serving
- Feature store: ลด operational burden สำหรับ ML engineers (maintain history, versions, sharing)
- อย่าเพิ่งทำ ML จนกว่าจะมี data foundation ที่ดี ทำ analytics ให้เก่งก่อน
- Data scientist มักดึงข้อมูลผ่าน notebook (Jupyter) เข้า pandas dataframe จากหลายแหล่ง (API, database, data warehouse, data lake) ต้องระวังเรื่อง credential handling (ห้าม hardcode ใน code) และเมื่อข้อมูลใหญ่เกิน local memory ต้องย้ายไป cloud notebook หรือ distributed execution (Dask, Ray, Spark)
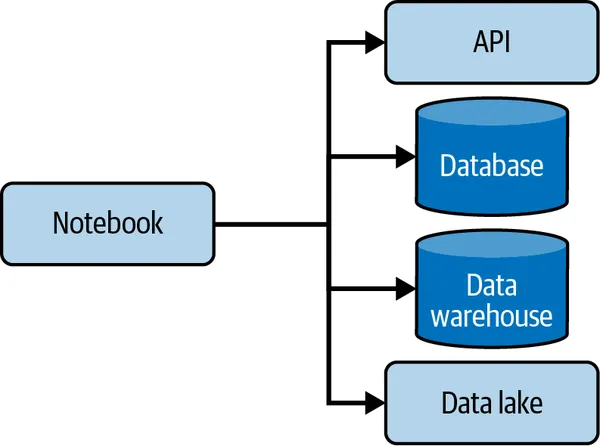 Figure 9-4. A notebook can be served data from many sources, such as object storage or a database, data warehouse, or data lake
Reverse ETL
ส่ง processed data กลับไป ยัง source systems (CRM, ad platforms)
- จาก antipattern → product category (Census, Hightouch)
- Marketing analysts เคยทำ manual ใน Excel ปัจจุบัน automate
- ระวัง feedback loop: ถ้า model ที่คำนวณค่ากลับไปมี error (เช่น bid model) อาจวนเพิ่มค่าเรื่อยๆ จนเผาผลาญ budget มหาศาล ต้องมี monitoring/guardrail
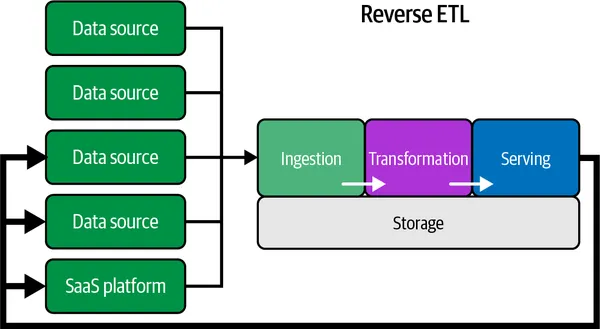 Figure 9-5. Reverse ETL
Undercurrents ในการ Serving
- Security: row/column-level security, encryption, masking, data obfuscation (ปลอมข้อมูลจริงเป็น synthetic/anonymized data ให้ user ใช้ได้โดยไม่หลุด PII)
- Data Management: data validation, SLA (Service-Level Agreement) monitoring, cost optimization
- DataOps: automation, monitoring, observability
- Orchestration: dependency management สำหรับ serving pipelines
Serving คือปลายทางสุดท้ายของ lifecycle แต่ก็วนกลับมาเป็น feedback loop เสมอ: build → learn → improve แล้วกลับไปเริ่มใหม่
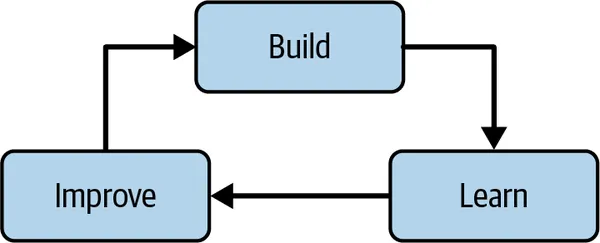 Figure 9-6. Build, learn, improve